要让网站有资格出现在ChatGPT Search结果中,先允许OAI-SearchBot抓取,并确认主机、CDN和WAF放行OpenAI公布的搜索爬虫IP;随后保证页面公开、稳定、正文可读,能直接回答具体问题并提供可核验事实。满足这些条件仍不保证排名、引用或展示。
OpenAI ChatGPT Search帮助明确,网站参与搜索的核心技术条件是允许OAI-SearchBot及其官方IP访问。AI搜索优化应先处理这个资格,再谈内容和来源。
第一步:区分搜索、训练和用户访问
OpenAI爬虫文档列出三类主体:OAI-SearchBot用于搜索结果发现与展示;GPTBot与基础模型训练相关;ChatGPT-User由用户请求触发,不用于决定Search收录。
可以允许搜索爬虫同时按企业政策限制训练爬虫;不要用GPTBot规则推断ChatGPT Search资格。
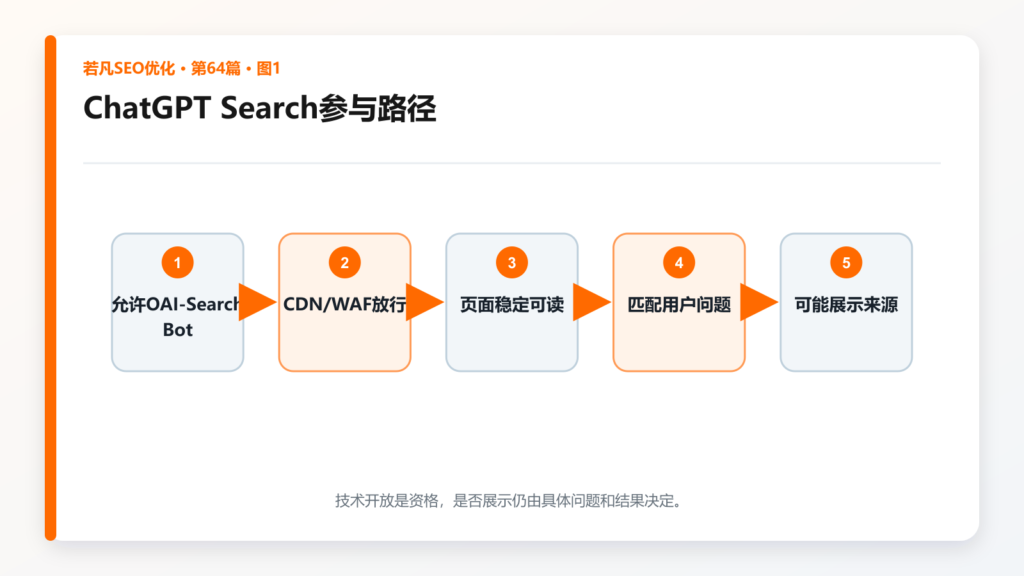
图1:技术开放是资格,是否展示仍由具体问题和结果决定。
第二步:检查robots、IP与WAF
robots.txt允许OAI-SearchBot只是第一层。还要确认防火墙、CDN机器人规则、地区封锁、速率限制和验证码没有把官方IP挡在外面。用服务器日志保存UA、IP、状态码、URL和时间,再对照官方搜索爬虫IP列表。
不要只按UA白名单,UA可以伪造;验证IP归属并保留安全策略。
第三步:让页面公开且稳定可读取
| 检查项 | 通过条件 | 常见失败 |
|---|---|---|
| HTTP | 200且无循环跳转 | 403、429、5xx |
| 访问 | 无登录/验证码 | 只对浏览器开放 |
| 正文 | 初始或稳定渲染可见 | API失败、空壳 |
| URL | 唯一稳定 | 会话参数、临时链接 |
| 来源 | 事实旁有依据 | 宣传口号无证据 |
| 更新 | 日期和版本可解释 | 过期价格/政策 |
如果页面只在点击后加载关键内容,或给机器人不同正文,先修交付,不要创建所谓AI专用镜像。
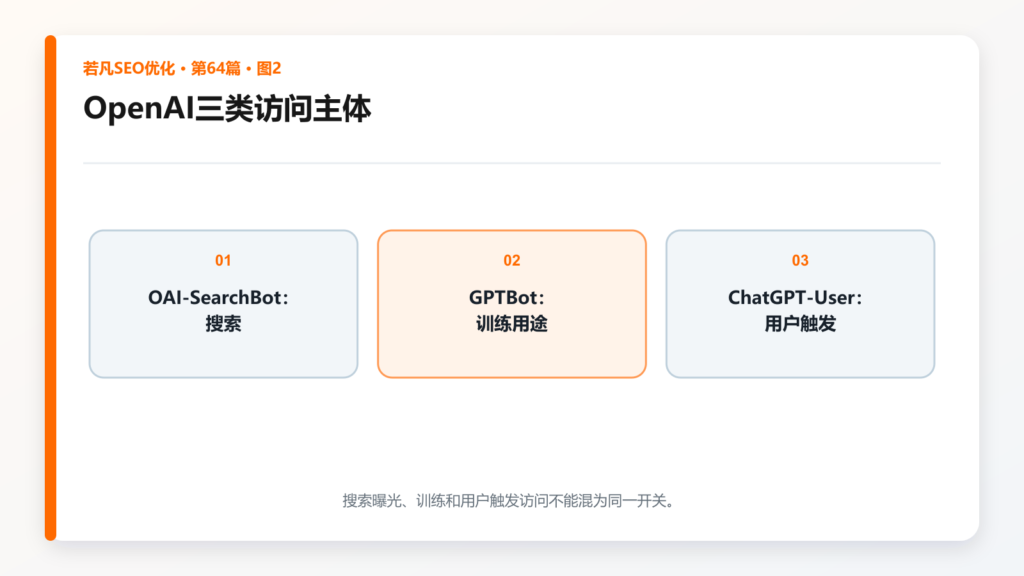
图2:搜索曝光、训练和用户触发访问不能混为同一开关。
第四步:围绕可回答的用户任务写页面
标题说明具体问题,开头给结论,正文提供条件、步骤、表格、限制和来源。产品页要有参数、兼容性、交期或政策;比较页要公开标准;价格页写清范围和日期。
结构清楚便于用户与系统定位信息,但没有“保证被ChatGPT引用”的字数、FAQ数量或Schema。
第五步:建立正常发现与品牌事实
关键页面从导航、分类和相关文章获得正常内链,保持canonical和Sitemap一致;官网名称、主体、产品与联系方式不冲突。GEO优化服务还会检查答案展示的第三方来源,但不能通过批量软文制造推荐。
品牌事实要有企业内部负责人和官方来源URL。更改公司名称、地址、产品状态或认证后,同步更新官网、主要目录与合作伙伴资料,并记录提交日期;第三方是否采用必须如实追踪。
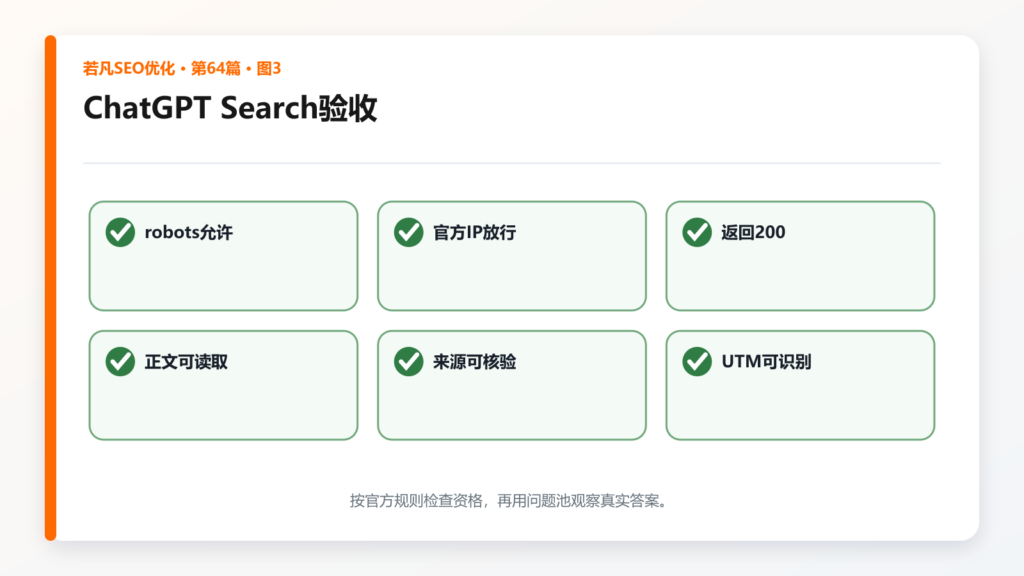
图3:按官方规则检查资格,再用问题池观察真实答案。
第六步:分开监测答案与引荐访问
OpenAI发布者FAQ说明,ChatGPT搜索引荐URL会带utm_source=chatgpt.com,可在分析工具中识别。与此同时,用固定问题池记录是否触发搜索、是否提及、是否展示链接、引用哪一页和事实是否准确。
分析报表需保留落地URL、日期、会话和转化事件,并把直接访问、其他推荐流量与ChatGPT标记分开。零引荐不等于零引用,答案中出现链接也不等于用户点击;两类数据要分别报告。
发现403、429或正文缺失时,先由技术SEO诊断修访问;技术通过后,再用AI可见度监测按平台、地区、语言和日期复测。
FAQ
允许OAI-SearchBot就一定会被引用吗?
不会。它只让网站具备被抓取和参与搜索的资格,实际展示取决于问题、相关性、可靠性等因素。
GPTBot被禁止会影响ChatGPT Search吗?
OpenAI把GPTBot和OAI-SearchBot用途分开;搜索资格主要看OAI-SearchBot。
需要提交Sitemap给OpenAI吗?
OpenAI当前官方说明没有提供类似Search Console的提交入口;应确保页面可发现、可访问并有正常内链。
llms.txt是必要条件吗?
不是。OpenAI官方搜索资格没有把llms.txt列为必要条件。
怎样统计ChatGPT带来的访问?
查看带utm_source=chatgpt.com的引荐,同时检查分析工具的渠道归类和同意模式。