用100个提示词建立AI可见度基线,可以先按任务分配:发现25题、比较25题、执行20题、信任核验20题、风险与售后10题,再在每层混合品牌与非品牌、核心产品和主要市场。固定平台、地区、语言、登录状态和日期窗口,保存全部答案与来源。
100题只是便于启动的样本规模,不代表完整市场,也不具备自动统计显著性。先用GEO提示词地图建立全集,再从真实业务权重抽样。
第一步:把100题配额分到业务层
先按产品线或收入重要度分配,例如核心产品50题、成长产品30题、战略新产品20题;再在每组按任务配额细分。若只有一个产品线,则把配额放到角色、场景和国家。
品牌题建议与非品牌题分开统计。品牌纠错可以多一些品牌题,发现度研究则必须保留大量非品牌题。
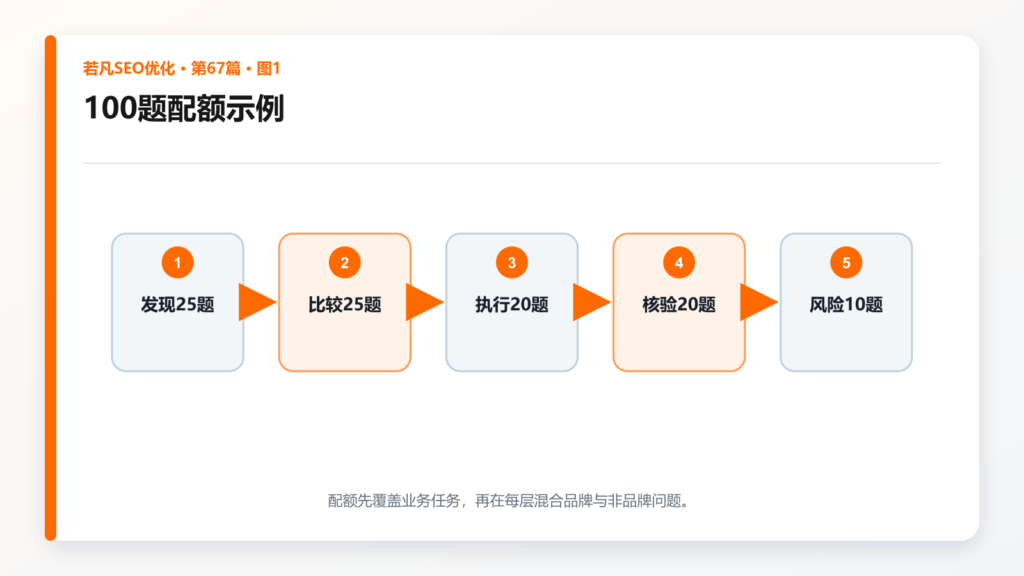
图1:配额先覆盖业务任务,再在每层混合品牌与非品牌问题。
第二步:冻结问题和测试环境
每题有唯一ID、文本、语言、地区、角色、任务、品牌属性、产品线和来源。平台记录产品入口、是否联网、是否登录、可见模型或版本与运行日期。看不到版本就写“未公开”,不要猜。
第三步:逐题保存原始答案
| 字段 | 取值示例 | 为什么保留 |
|---|---|---|
| 是否触发AI回答 | 是/否/故障 | 区分未提及 |
| 品牌提及 | 是/否 | 计算提及率 |
| 推荐语境 | 推荐/中性/负面 | 解释出现方式 |
| 官网引用 | URL/无 | 记录可见来源 |
| 第三方来源 | URL列表 | 找事实来源 |
| 事实准确性 | 准确/部分/错误 | 安排纠错 |
| 原始证据 | 文本/截图 | 可复核 |
| 样本ID | Q001—Q100 | 跨周期对应同一题 |
只保存汇总百分比,无法在下一轮解释变化。
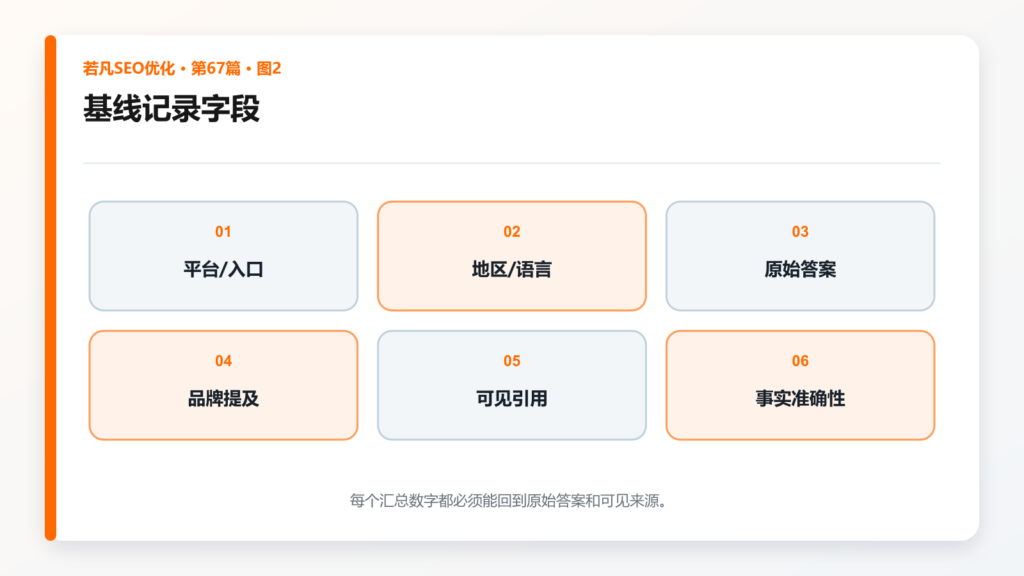
图2:每个汇总数字都必须能回到原始答案和可见来源。
第四步:按固定分母计算五项指标
触发率=触发题数÷有效题数;品牌提及率=提及题数÷适合出现品牌且触发的题数;官网引用率=展示官网题数÷有可见来源的触发题数;准确率=准确题数÷提及品牌题数;推荐语境率=推荐题数÷适合推荐的触发题数。
Ahrefs指标文档也区分mentions、citations和share of voice,团队需要先统一定义再使用工具。
第五步:把结果分成修复和观察
主体、产品能力、认证、地址等重大错误进入修复;官网无法访问或正文缺失进入技术任务;缺少关键比较信息进入内容任务;未提及但没有明显故障的题进入观察,不把它当作违规或阻断。
GEO审计可把100题基线连接到品牌、内容、来源和技术四层。
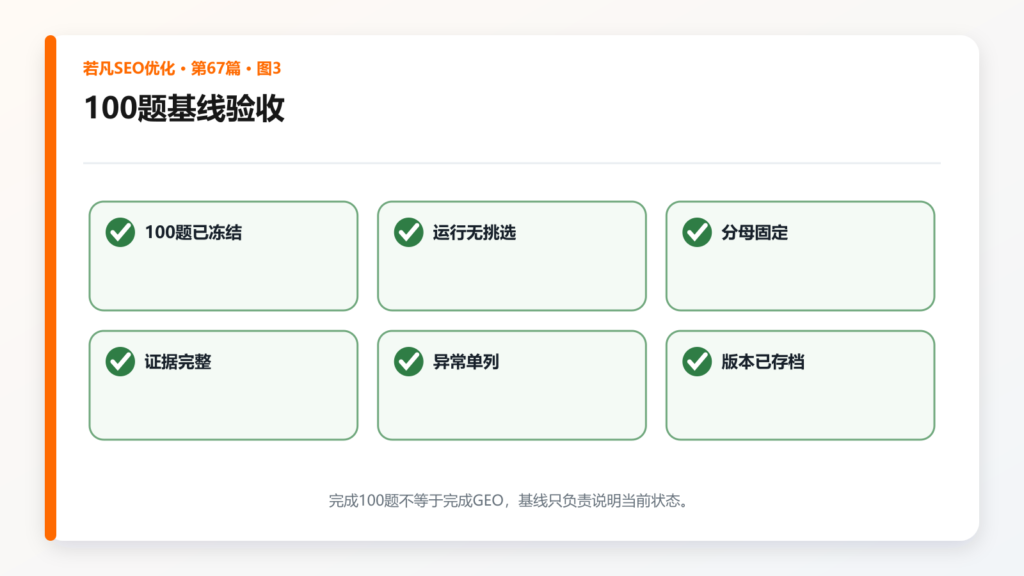
图3:完成100题不等于完成GEO,基线只负责说明当前状态。
第六步:同条件复测
首次基线后可月度或季度复测,核心问题按月、长尾按季度。Ahrefs提示词追踪支持不同频率,但更高频会消耗更多检查;Semrush默认额度同样要求团队控制样本。
复测表先显示100题中有效、故障和未触发各多少,再计算比例。发生页面更新或品牌事件时写入时间线;只能说明变化与动作同时发生,不能用单次前后对比宣称因果。
最终交付应有提示词CSV、原始答案、来源台账、指标字典、问题清单和复测日期。需要持续执行时,将其纳入AI可见度监测或GEO优化服务的月度范围。
FAQ
为什么是100题,不是50或500题?
100题便于中小团队覆盖主要层级并人工复核;实际规模应根据业务复杂度和预算调整。
100题需要每天跑吗?
通常不需要。月度或季度更适合趋势,重大改版或纠错可增加触发式复测。
同一个问题在多个平台算几条?
应分别记录为平台级观察;汇总时明确分母是问题数还是问题×平台运行数。
未触发AI回答要算0分吗?
应单独标记未触发,不直接等同未提及;不同平台和入口的触发机制不同。
基线后最先修什么?
先修重大事实错误和核心页面访问失败,再处理高价值任务中的内容与来源缺口。